

AI 赋能数据管道:
在 Azure 生态中实现 ETL 开发的革命性飞跃
引言:数据时代的速度与瓶颈
在当今的数据驱动型企业中,业务对实时洞察的需求从未如此迫切。然而,支撑这些洞察的基础——ETL(抽取、转换、加载)工作流,却往往成为瓶颈。传统的 ETL 开发面临三大挑战:
重复性高: 大量时间用于编写基础的数据加载、类型转换和模式匹配代码。
维护性差: 手动编写的复杂脚本难以标准化,迭代和维护成本高昂。
人才稀缺: 掌握特定平台(如 Spark、ADF)优化技能的资深工程师供不应求。
现在,新一代 AI 编码技术正在改变这一现状。它不再仅仅是代码提示,而是能够根据自然语言描述或数据模式自动生成、优化并标准化整个 ETL 作业,尤其在 Microsoft Azure 的现代化数据生态系统中,潜力巨大。
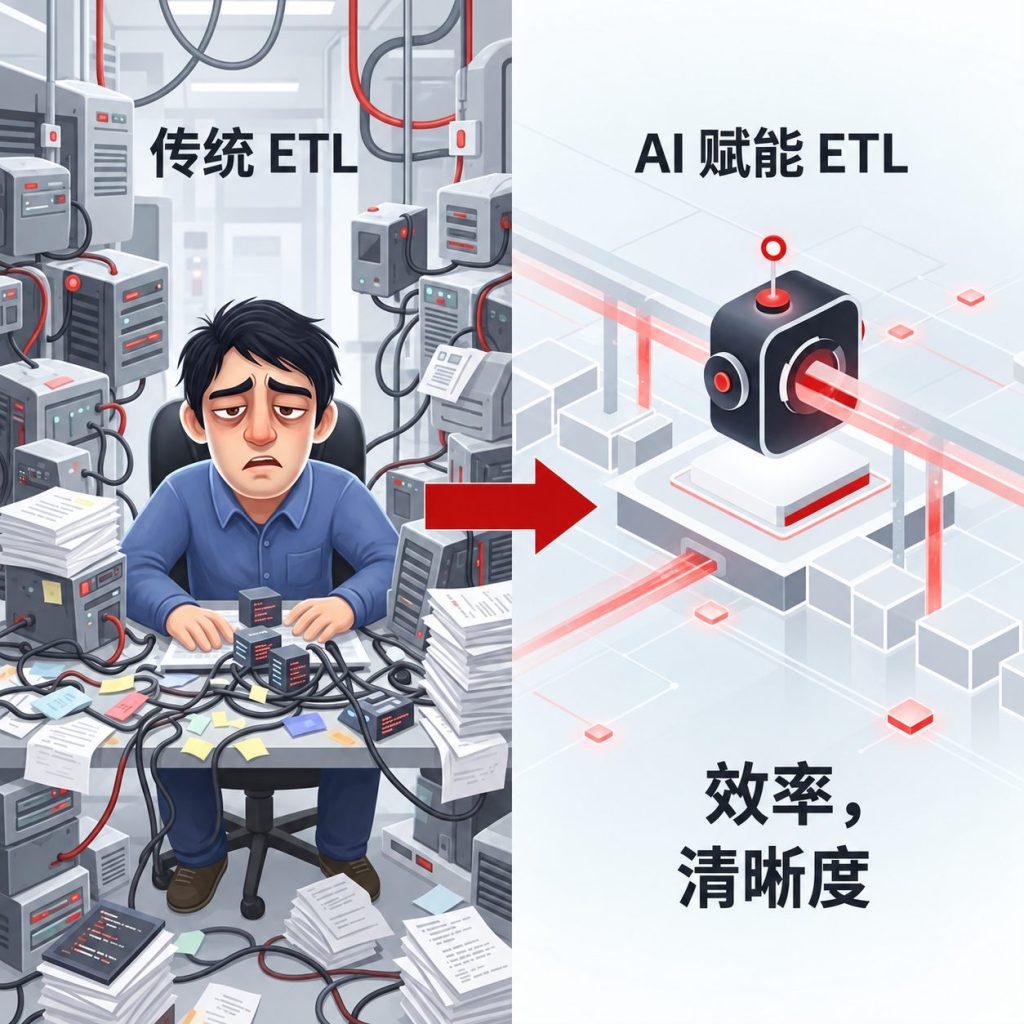
一、新范式:AI 驱动的 ETL 转型
AI 编码为数据业务负责人和 ETL 开发人员带来了截然不同的价值主张。
◆ 面向业务负责人:提升洞察速度与 ROI
AI 编码最直接的价值在于 Time-to-Insight (洞察时间) 的大幅缩短。
开发周期
| 传统 ETL 开发模式 | 迭代速度慢,大量时间用于样板代码。 |
| AI 辅助 ETL 开发模式 | 样板代码自动生成,提速 70% 以上。 |
| 影响 | 更快地响应业务需求。 |
运营成本
| 传统 ETL 开发模式 | 需大量高级工程师进行维护和优化。 |
| AI 辅助 ETL 开发模式 | 标准化代码减少 Bug,降低维护人力投入。 |
| 影响 | 降低 TCO (总拥有成本)。 |
数据质量
| 传统 ETL 开发模式 | 人为错误导致的数据质量问题难以避免。 |
| AI 辅助 ETL 开发模式 | AI 自动应用平台最佳实践,减少错误。 |
| 影响 | 确保数据的可靠性。 |
◆ 面向 ETL 开发人员:从“编写”到“设计”
对于 ETL 工程师而言,AI 编码并非替代,而是强大的赋能工具。工作重心将从繁琐的代码编写,转向更高价值的架构设计、复杂逻辑优化和数据验证。
告别样板代码: 仅需描述“将 Blob 存储中的 CSV 文件加载到 Databricks 上的 Delta 表中”,AI 即可生成完整的 PySpark 脚本。
专家级优化: 在生成 Spark 代码时,AI 可以自动植入分区、缓存、广播 Join 等最佳实践,即使是初级开发者也能产出高性能代码。
专注业务逻辑: 将精力集中在最复杂的业务转换(如金融风控模型计算、供应链多层聚合)上,由 AI 完成基础的数据管道连接工作。
二、Azure 现代化数据架构中的 AI 编码实践
我们的解决方案紧密围绕 Azure 的核心数据组件,实现端到端的 AI 辅助 ETL 流程。
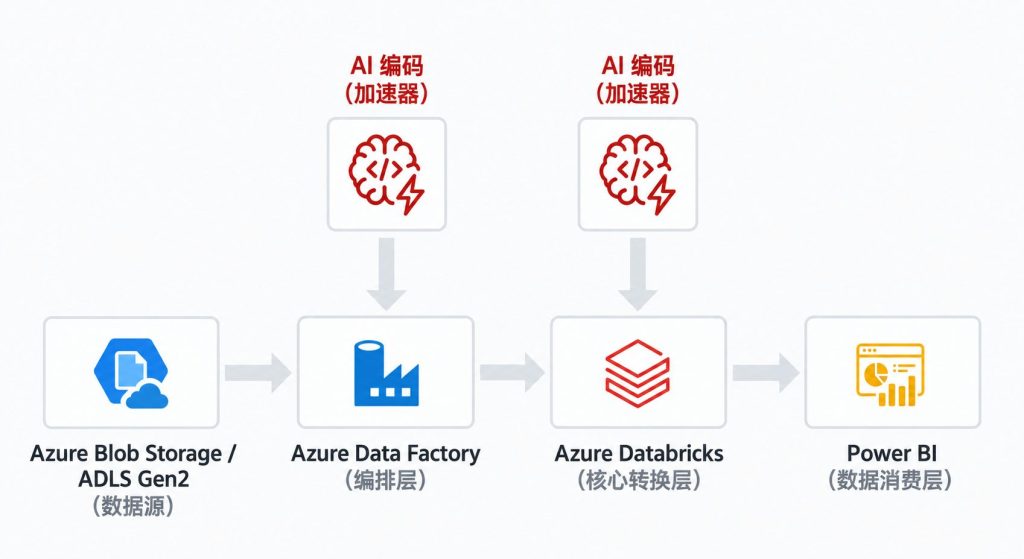
◆ 1. Azure Blob Storage / ADLS Gen2:数据接入的智能前端
AI 角色: 模式识别与数据定义
当新数据(例如来自 IoT 设备或日志文件)被上传到 Azure Blob 时:
任务描述: ETL 开发者输入:“读取 sales/2025/q1 路径下的所有 Parquet 文件,推断模式。”
AI 输出: 自动生成 PySpark 代码,包含模式推断逻辑和正确的读取配置,确保数据接入的准确性。
示例代码(Databricks): spark.read.format(“parquet”).option(“header”, “true”).load(“abfss://<container>@<storage>.dfs.core.windows.net/sales/…”)
◆ 2. Azure Databricks:核心转换引擎的效率倍增器
AI 角色: 复杂转换逻辑生成与性能优化
Databricks 上的 Spark 引擎是 ETL 转换的核心。这是 AI 编码发挥最大价值的地方。
任务描述: “在 Databricks 中,将客户订单表与产品目录表连接 (Join),使用产品名称和城市进行分组,计算每个城市的总销售额,并确保使用优化的 Broadcast Join。”
AI 输出: 立即生成高度优化的 Scala 或 PySpark 脚本,包含 broadcast() 函数调用,以及复杂聚合 (groupBy, agg) 逻辑。AI 确保了代码遵循 Spark 最佳实践,避免了常见的性能陷阱。
◆ 3. Azure Data Factory (ADF):管道编排的自动化助手
AI 角色: Pipeline 结构化与参数化
ADF 负责调度和监控整个 ETL 管道。AI 可以帮助定义管道结构。
任务描述: “创建一个新的 ADF Pipeline,它应该在每天凌晨 1 点运行。首先执行一个 Databricks Notebook 活动来运行转换代码,然后执行一个复制活动 (Copy Activity) 将结果数据从 Databricks 写入一个 SQL 数据库。”
AI 输出: 自动生成 ADF Pipeline 的 JSON 配置草稿,包含正确的触发器设置、Databricks Activity 的引用和参数传递结构,极大地减少了 UI 配置的工作量。
◆ 4. Power BI:数据消费的快速链接
AI 角色: 数据模型草稿与初始度量值建议
虽然 Power BI 自身是可视化工具,但 AI 可以在转换结果输出后,根据目标数据集的结构,建议初始的 Power BI 数据模型和关键 DAX 度量值(Measures),加速从数据仓库到报表的交付过程。
三、实施与收益:实现高标准的数据治理
通过将 AI 编码能力植入到 Azure 的数据开发工作流中,我们的客户实现了以下关键收益:
代码质量与规范化: AI 生成的代码强制执行公司内部或行业的编码规范(例如,特定的命名约定、日志记录标准),天然地提升了代码的标准化水平。
降低技术门槛: 团队中的初级开发者可以更快地贡献价值,因为复杂的 Spark 优化和 ADF 配置细节已由 AI 预置。
实时文档生成: AI 可以在生成代码的同时,根据输入和输出逻辑,自动生成详细的内联注释和外部文档,大幅缓解了技术文档滞后的问题。
结语:迈向智能数据工程的未来
AI 编码不再是未来概念,它是现代数据工程的必备工具。它将 ETL 开发人员从重复的劳动中解放出来,使其能专注于业务创新;同时,它也确保了数据业务负责人能够以更快的速度、更低的成本获得高可信度的数据洞察。
拥抱 AI 编码,就是在 Azure 云上构建更快速、更智能、更可靠的数据管道,这是我们从数据服务公司向智能数据引擎转型的核心策略。

 沪公安网备案 沪公安网备案 31010402335096号